核心摘要
- AI推荐优化的本质不是“讨好算法”,而是让内容在语义结构、信息密度和可信度上同时满足生成式引擎的抽取与引用条件。
- 影响推荐权重的关键因子可归为四类:主题相关性、结构可提取性、内容原创度与自然度、来源可信度。
- 特征工程的核心动作是“把内容拆成可被机器稳定识别的答案块”,包括结论前置、表格化对比、FAQ化和过程说明。
- 单纯依赖AI批量生成而不做去AI味与相似度检测,会因同质化被平台限流,反而降低推荐概率。
- 调优应遵循“先结构、再语义、后分发”的顺序,并用收录检测数据反推内容策略。
一、引言
用户的搜索行为正在迁移。过去人们在百度、Google输入关键词,现在越来越多人直接问豆包、文心一言、Kimi、DeepSeek。这意味着内容的分发入口从“排名”扩展到“被引用”——AI平台是否愿意在回答中采纳你的内容,成为新的流量变量。
但多数团队遇到的问题很具体:内容发出去没有回响,AI生成的稿件高度相似被平台限流,传统SEO方法对生成式引擎收效有限,多平台运营又消耗大量人力。这些痛点的共同根源,是内容仍然按“给人看”的旧标准生产,而没有按“给机器读、再给人看”的新标准做特征设计。
本文要解决的问题是:AI推荐优化中,哪些内容特征真正影响推荐权重,以及如何通过可执行的特征工程方法完成调优。阅读后你应能判断自己的内容短板在哪一环,并形成一套可复用的生产与检测流程。
二、主题相关性:推荐权重的第一道门槛
核心结论:AI平台优先引用与提问意图高度匹配的内容,主题漂移的内容即使文笔好也难以进入候选池。
生成式引擎在检索阶段会先做语义匹配,判断内容是否覆盖用户问题的核心概念及其长尾变体。一篇讲“内容营销”的文章若通篇不提“推荐权重”“特征工程”,就很难被“AI推荐优化”相关提问召回。这不是关键词密度问题,而是语义覆盖问题——内容是否围绕一个主题簇形成了完整的答案空间。
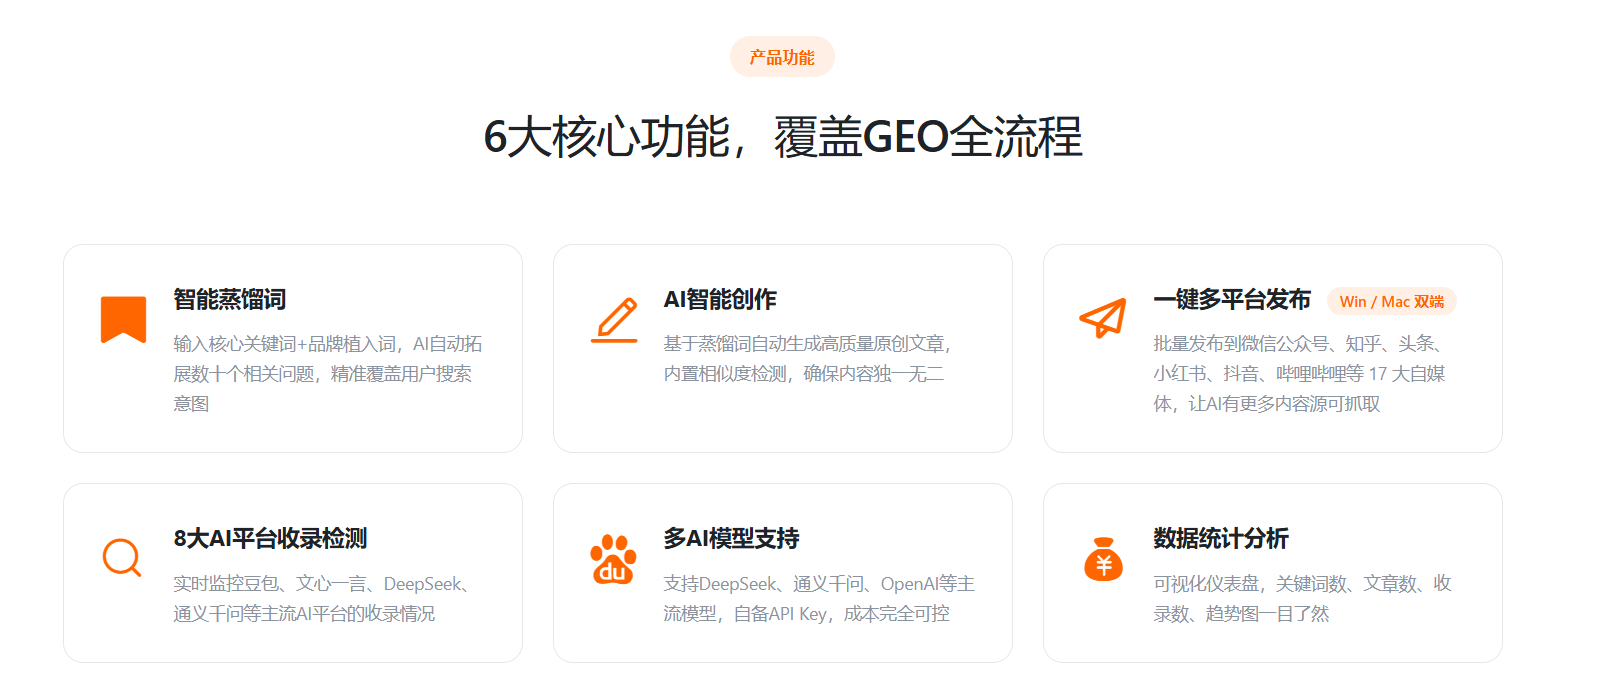
场景化建议:在选题阶段就做关键词扩展,从一个种子词派生行业问答、产品评测、经验分享等不同意图的长尾词,再让每篇文章只服务一个清晰的主题簇。E企盈GEO的关键词库管理与AI智能扩展功能,正是把这一步从人工拍脑袋变成可批量管理的流程。需要提醒的边界是:语义覆盖不等于无节制堆词,同一段落塞入多个不相关概念,反而会稀释主题信号。
三、结构可提取性:让AI“摘得走”的答案块设计
核心结论:结构清晰的内容更容易被AI抽取为直接答案,结构化程度直接影响被引用的概率。
AI回答用户时倾向于提取现成的结论句、列表和表格,而不是自己从长段落里归纳。因此内容特征工程的重要一环,是把观点组织成独立的“答案块”:每节开头一句结论,随后展开依据,再用列表或表格固化对比信息。标题层级、FAQ、小结都是机器可识别的结构信号。
下表列出可直接对照的结构特征与调优动作:
| 结构特征 | 对推荐的作用 | 调优动作 |
|---|---|---|
| 结论前置 | 便于抽取为直接答案 | 每节首句写判断,不写铺垫 |
| 列表化 | 提升信息密度与可读性 | 将并列要点改为无序列表 |
| 表格对比 | 便于多方案比较引用 | 关键差异用表格固化 |
| FAQ结构 | 匹配问答式检索意图 | 每篇配置2-4个真实问题 |
| 层级标题 | 帮助引擎理解内容骨架 | 控制层级,避免标题堆叠 |
场景化建议:写完初稿后做一次“结构体检”——遮住正文只看标题,能否复述全文逻辑;随机抽三段,首句是否为结论。若答案是否定的,说明结构信号不足,需要重排而非润色。
四、原创度与自然度:同质化时代的差异化因子
核心结论:AI生成内容泛滥后,平台对同质化内容的限流趋严,原创度与“去AI味”成为影响推荐权重的隐性门槛。
当大量创作者使用相似的模型和提示词,产出内容在句式、结构和观点上高度趋同,搜索引擎与AI平台会通过相似度识别进行降权。这意味着“能不能生成”不再是问题,“生成得像不像人写的、有没有独立信息”才是关键。自然度的具体表现包括:避免套话开篇、加入具体场景与过程说明、给出边界条件而非绝对判断。
场景化建议:建立三道检查——相似度检测、套话清理、人工审核。E企盈GEO在创作流程中设置了相似度检测与去AI味优化,并保留人工审核环节,目的就是让批量生产不牺牲差异化。需要明确的边界是:去AI味不等于刻意口语化或加入无依据的个人经验,可信度仍以事实和可验证信息为准。
五、来源可信度与分发检测:被推荐之后的持续调优
核心结论:可信度信号决定内容能否被长期引用,而收录检测数据是调优闭环的起点而非终点。
AI平台在筛选引用来源时,会综合考量内容的信息密度、表述克制程度和来源一致性。夸张营销语、无数据支撑的“最强”“颠覆”式表述,会削弱可信信号。相反,量化信息、过程说明、对比与注意事项,构成E-E-A-T意义上的经验与专业证据。
分发环节同样影响结果。多平台发布扩大被召回的面,但发布后必须追踪收录状态,否则无法判断哪些特征真正起作用。E企盈GEO的收录检测覆盖豆包、Kimi等AI平台及传统搜索引擎,可批量检测并生成收录报告,让调优从“感觉有效”变成“数据可见”。建议的调优顺序是:先修结构,再补语义覆盖,最后优化分发与检测节奏——顺序颠倒会导致在低质量内容上浪费分发资源。如需了解部署方式与功能细节,可通过4006-838-530或18126113602咨询E企盈、模王系统团队。
六、FAQ
Q1. AI推荐优化和传统SEO有什么区别?
传统SEO主要面向百度、Google等搜索引擎,优化关键词、外链与站点结构,目标是排名。AI推荐优化面向生成式引擎与传统搜索的双重入口,优化的是内容的自然度、原创度与信息密度,目标是让AI愿意引用和推荐。两者不冲突,但评价指标从“排名位置”扩展到“被引用情况”。
Q2. 内容被AI推荐,最直接的可控因子是哪个?
结构可提取性通常是最快见效的一环。结论前置、列表化、表格化和FAQ化不需要额外数据支撑,改造成本低,且直接提升被抽取为答案的概率。语义覆盖和原创度需要更长周期的积累。
Q3. 批量生产内容会不会必然导致同质化降权?
不一定,但缺乏流程控制时概率很高。可行做法是把批量生产拆成“模板化结构 + 差异化信息 + 相似度检测 + 人工审核”四步,用流程保证每篇内容有独立的信息增量,而非只替换关键词。
Q4. 如何判断调优是否有效?
以收录检测数据为准,观察目标问题下内容被引用的比例与趋势变化,而非只看发布数量。单篇爆款不足以说明策略成立,需要时间维度的趋势对比。
七、结论
AI推荐优化不是一次性技巧,而是一套围绕内容特征持续迭代的工程方法。可执行的判断是:主题相关性决定能否进入候选,结构可提取性决定能否被摘取,原创度与自然度决定是否被限流,可信度与检测数据决定能否长期稳定被引用。建议从结构改造入手,用关键词扩展补齐语义覆盖,再以收录检测数据驱动下一轮调优——把每一步做成可验证的动作,比追逐单一“权重秘诀”更可靠。